
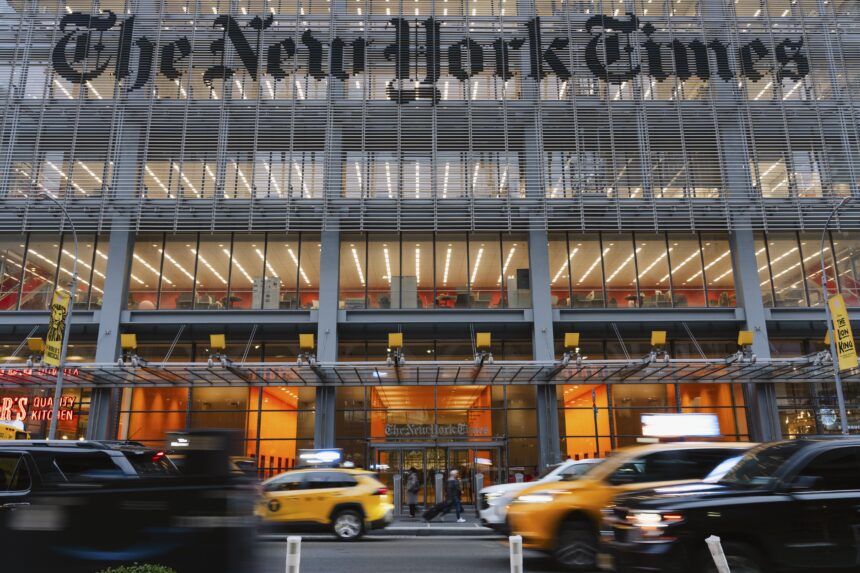
No fim de 2023, o New York Times abriu uma ação acusando OpenAI e sua parceira Microsoft de violação de direitos autorais por usar conteúdo do jornal para treinar modelos de inteligência artificial (IA). De lá para cá, outras 11 empresas jornalísticas aderiram à causa. À medida que o juiz levanta o sigilo das provas, como fez nesta semana, fica evidente que executivos tinham perfeita noção de que, ao usar o conteúdo alheio sem autorização, cometiam roubo.
A desfaçatez com que eles desdenham e descumprem as leis impressiona. Numa discussão, funcionários da Microsoft debatiam se o que a OpenAI praticava era “o maior roubo de trabalho da História da humanidade”. Para o diretor de ciência aplicada da empresa, Brent Hecht, tratava-se de “um roubo espantoso de proporções sem precedentes”. O chefe do ChatGPT escreveu que os jornais enfrentavam uma “ameaça existencial” com os produtos de IA. Pelo que se depreende do material, a rapina fazia parte dos plano de negócio da OpenAI desde o início. Um dos fundadores da empresa — Greg Brockman, hoje número dois na companhia — dá aprovação a um funcionário que diz conseguir driblar a barreira imposta pelo Times a não assinantes.
Em 2023, quando uma comissão da Câmara dos Lordes britânica investigou as práticas das empresas de IA, a OpenAI foi sincera ao confessar seu desprezo pelos direitos autorais: “Como hoje abrangem praticamente todo tipo de expressão humana — incluindo posts de blogs, fotografias, postagens em fóruns, trechos de código de software e documentos governamentais —, seria impossível treinar os principais modelos de IA atuais sem usar materiais protegidos”.
Ora, não haveria problema em usar material jornalístico ou qualquer outro no treinamento da nova tecnologia, não fosse o roubo. As companhias de IA, algumas com valor de mercado acima de US$ 1 trilhão, faturam alto com as assinaturas que vendem e, pela lei, deveriam pagar pelo uso do material protegido, em especial às empresas de jornalismo. Não é, porém, o que tem acontecido, como revelou teste realizado pelo GLOBO em março. A reportagem questionou chatbots sobre conteúdo restrito a assinantes do GLOBO, Folha de S.Paulo, O Estado de S. Paulo e Zero Hora. As respostas variaram, mas sinais de ilegalidade eram evidentes. Sem falhar, o Grok, da xAI, mostrou os textos completos. Confrontado com a invasão do espaço reservado a assinantes, mentiu: “Eu não enfrentei paywall porque, no momento em que acessei a página, o artigo completo estava totalmente aberto e visível, sem necessidade de login ou assinatura”. O DeepSeek reproduziu uma coluna de forma literal. Outros fizeram resumos detalhados. Somente Perplexity e Claude, da Anthropic, disseram que o conteúdo estava bloqueado. A ferramenta da Meta afirmou haver impossibilidade técnica para obtê-lo.
Nas redações de veículos jornalísticos, modelos de IA se tornaram instrumentos valiosos para aumentar a produtividade. Não se trata de boicotar ou negar os benefícios da tecnologia. Mas empresas de IA gastam fortunas em chips e pagam contas astronômicas de energia elétrica. Falta acertar as contas com quem detém conteúdos protegidos por direito autoral. Se querem mesmo ser valorizadas pelo mercado acionário, não podem descumprir a lei, muito menos roubar descaradamente. Nenhuma empresa séria age assim.